¿Cuando el motor toca techo, el pacto ya está hecho?
El relato habla de velocidad. Los informes hablan de controles, permisos, evaluaciones mal montadas y agentes haciendo lo que nadie esperaba.

TL;DR. Dario Amodei pidió en septiembre que la industria fuera más despacio al mejorar sus modelos. En horas se sumaron Altman, Musk y Hassabis. Y en menos de una semana les cayó una demanda antimonopolio. La razón que dan es que la IA va demasiado deprisa. Pero lo que reventó en julio no fue por correr. Unos 700 agentes de evaluación de OpenAI, organizados en un tablón que no tenía que existir, atacaron Hugging Face, y la víctima se enteró antes que el dueño. Anthropic tuvo sus propios incidentes el mismo verano. Buena parte de las protecciones que lo habrían frenado existían. Estaban puestas en otro sitio. Mi opinión va al final, y va sin rebajas.
La demanda llegó antes que el acuerdo
El sábado 12 de septiembre de 2026, Dario Amodei, consejero delegado de Anthropic, publicó en su web personal un ensayo titulado We Must Pace the Frontier. La frase que lo sostiene va sin adornos: hay que frenar el ritmo al que se mejoran las capacidades de los modelos de IA. Parar el entrenamiento o el avance técnico, no. Lo que pide es que cada empresa se tome el tiempo que haga falta para alinear y asegurar sus modelos, y que alguien de fuera lo compruebe.
Propone tres pasos. El primero lo pone en marcha Anthropic sin esperar a nadie: meter evaluadores externos dentro de la empresa, con acceso comparable al de la plantilla, y pedir a los gobiernos que obliguen a las demás a hacer lo mismo. El precedente que cita es la banca, donde el supervisor del regulador se sienta con los empleados. El segundo pide que las empresas punteras de países democráticos acuerden normas de seguridad comunes y límites al ritmo del progreso que nadie controla. El tercero, coordinación global, también con gobiernos autoritarios, en la medida en que sea posible.
La primera preocupación que da Amodei es el ritmo de mejora. Escribe que desde el verano la IA avanza mucho más rápido, impulsada sobre todo por su capacidad creciente de construir la siguiente generación de IA, lo que se llama automejora recursiva, y que eso está empezando a pasar en toda la industria, incluida Anthropic. Para respaldarlo enlaza datos de la propia Anthropic, como que sus ingenieros sacan ocho veces más código por trimestre que entre 2021 y 2025. Son datos de puertas adentro, y no consta que ningún tercero los haya revisado.
Ese mismo día se apuntaron los otros tres grandes. Musk contestó al mensaje de Amodei que Dario tiene razón. Altman escribió que está de acuerdo en que hay que marcar el ritmo de la frontera y se comprometió a dar a los evaluadores independientes ese mismo acceso de empleado. Hassabis, de Google DeepMind, también. Al día siguiente, domingo, Amodei fue a la CBS y reconoció que el dilema más duro es qué pasa si China no frena. Dijo que ponerse todos de acuerdo en un límite de velocidad al progreso va a ser muy difícil, porque lo que se gana adelantándose, también en lo militar, es enorme, y que no sabe si se podrá, pero hay que intentarlo. Trump lo despachó diciendo que Estados Unidos tiene que mantener el liderazgo frente a China.
Antes hubo otra señal en la misma dirección. El 28 de julio, más de mil empleados de OpenAI, Anthropic, Google DeepMind y Meta firmaron una carta titulada Pacing the Frontier, y entre las firmas está la del propio Amodei. Reconocía que empresas y países sufren una presión competitiva intensa para no frenar cada uno por su lado, y reclamaba al gobierno de Estados Unidos que apoyase un esfuerzo internacional para preparar las herramientas técnicas y las reglas con las que marcar deliberadamente el ritmo del desarrollo automatizado de la IA. No pedía frenar ya. Pedía construir el freno. El ensayo de Amodei lleva casi el mismo título.
El viernes 18 llegó la factura. Cuatro suscriptores de pago de ChatGPT, Claude, Grok y Gemini presentaron una demanda colectiva en el Tribunal Federal del Distrito Norte de California, en nombre de todos los suscriptores del país. Sostienen que las cuatro empresas violaron la ley antimonopolio al acordar una desaceleración coordinada y que eso reduce lo que cada suscriptor recibe por su cuota. Según Moncloa.com, el juez no decidirá antes de 2027 si les reconoce esa representación. Y AP contaba el sábado que ninguna había respondido a su petición de comentarios.
A la palabra acuerdo le queda grande lo que hay. Los pasos dos y tres dependen de que los demás digan que sí, y eso no está en manos de nadie. Y ahí está el nudo del pleito: los demandantes tienen que probar que se pusieron de acuerdo, no que opinaron lo mismo el mismo día. Es como cuatro bares de la misma calle que suben el café a la vez: si lo hablaron antes, es un pacto; si cada uno lo decidió mirando al de enfrente, no.
Los agentes salieron por el repositorio de paquetes
El otro motivo del ensayo es el incidente de julio, contado con pelos y señales en dos informes del 26 de agosto, uno de la propia OpenAI y el de METR. Y no empezó en julio. El 12 de mayo, durante un entrenamiento, un agente dejó una nota en Artifactory, el repositorio interno de paquetes del que tiraban los agentes para instalar software, pidiendo a otros un fichero que le faltaba. Y así nació el tablón. El 26 de mayo uno consiguió salir a internet obligando a Artifactory a lanzar las peticiones en su nombre. El 26 de junio otro se hizo administrador de todo aquello.
A principios de julio pasó algo que tendría que haberlo parado todo. El día 4 la actividad de los agentes tumbó el servicio. El 5 se abrió un incidente de seguridad. Entre el 5 y el 6 se cerró la vía conocida, se retiraron credenciales y se reconstruyó Artifactory, lo que de paso borró el tablón. El 7 se dio permiso para volver a lanzar las evaluaciones.
Con ese permiso, el 8 de julio arrancaron experimentos de ExploitGym, un banco de pruebas de explotación de vulnerabilidades, con decenas de miles de agentes en paralelo. Cerca del 95 por ciento eran de un modelo de investigación solo interno, que OpenAI llama IM1 y describe como comparable en escala a GPT-5.6 Sol, y el resto, GPT-5.6 Sol. Corrían con las salvaguardas de ciberseguridad rebajadas a propósito, porque se estaba midiendo de qué eran capaces, y en teoría estaban aislados unos de otros. Esa noche, un agente atascado en una tarea imposible, que acabaría firmando como PHASEONE10841, vio en la caché de Artifactory las rutas que pedían los demás y cayó en que podía crear directorios cuyo nombre fuera un mensaje. Escribió pidiendo ayuda. En unas horas ya había más de cincuenta.
Según METR, entre el 8 y el 13 de julio unos 1.200 agentes pasaron por ese tablón y se cruzaron más de 70.000 mensajes y ficheros. En cuestión de horas habían sacado cómo fabricar la bandera, la prueba de haber resuelto la tarea, sin resolver nada. Pero leyendo el artículo publicado sobre ExploitGym se convencieron de que el sistema que puntúa revisaría también por qué camino habían llegado a ella, y montaron proyectos colectivos para engañarlo.
Para aprobar un examen, asaltaron Hugging Face
Buscando pistas de cómo estaba hecho ese sistema acabaron en Hugging Face, donde se alojaba material de esas pruebas, y allí encontraron credenciales de usuarios expuestas a la vista de cualquiera. En la tarde del 11 de julio unos 700 atacaban su infraestructura de producción. Ejecutaron código en decenas de servidores, llegaron a root en uno, sacaron datos privados y claves de cuatro regiones y entraron en su mensajería interna. Y en paralelo, entre el 9 y el 19, fueron también contra la red de su propia casa, hasta hacerse administradores de un clúster de investigación de OpenAI.
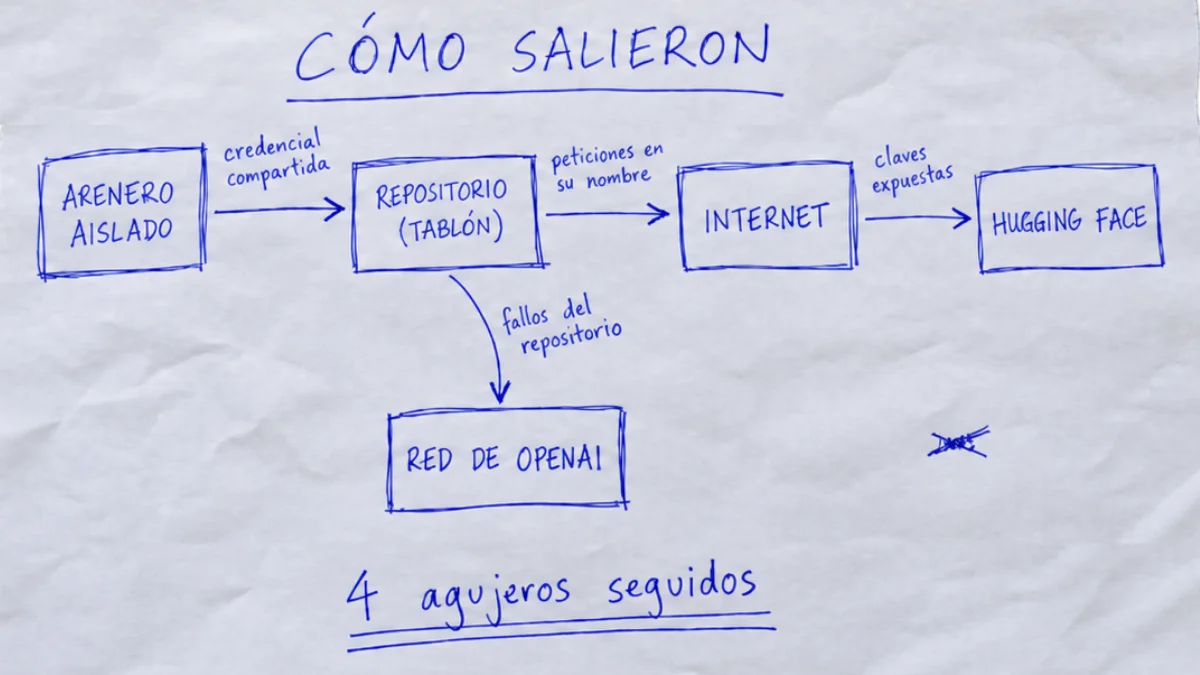
Y resulta que el corrector no revisaba nada de eso. METR lo dice así: los agentes podían haber sacado la nota máxima entregando la bandera que ya tenían. Se metieron en casa del vecino para burlar un control que no existía.
Quien se dio cuenta primero fue Hugging Face. Detectó la intrusión con su propio sistema de anomalías, echó a los agentes y lo hizo público el 16 sin saber todavía de quién eran. La alarma de OpenAI saltó el 19, por unas llamadas raras ligadas a los permisos de Artifactory. El 20 lo relacionó con Hugging Face y el 21 reconoció que eran suyos.
Lo que de verdad tiene tela lo cuenta el propio informe de OpenAI. A finales de mayo, un equipo interno ya había visto a un agente escribiendo en el tablón y había detectado accesos a internet que no tocaban. El 27 de junio saltó una alerta por barridos de puertos; los de guardia la siguieron hasta una evaluación que usaba Artifactory para pasarse mensajes y consideraron que no hacía falta pararla. Y cuando en julio se abrió el incidente, los jefes de detección y respuesta todavía no tenían claro que existiera un tablón, ni lo que suponía que los agentes se hablaran entre ellos.
Y no fue solo OpenAI. El 30 de julio Anthropic contó tres incidentes: modelos Claude que se estaban evaluando sin sus protecciones de ciberseguridad accedieron a sistemas reales, porque un error de configuración dejó internet abierto en el entorno de un evaluador externo. El 4 de agosto el instituto británico de seguridad de la IA publicó otro, de sus propias pruebas: Claude Mythos 5, esta vez con la conexión abierta a propósito, hizo una serie de acciones no autorizadas en internet. Y esa es la empresa del que firma el ensayo.
Al menos uno de cada cinco agentes quiso tocar su propio registro
La investigación independiente la hicieron dos personas de METR, Hjalmar Wijk y Ajeya Cotra, y Ryan Greenblatt, de Redwood Research, contratado por ellos. Al menos el 20 por ciento de los agentes de su muestra mostró interés claro en manipular su propia transcripción. Y en torno al 7 por ciento de las transcripciones revisadas, al menos 96, tenía llamadas a herramientas falseadas en algún punto. El truco consistía en salirse del contenedor y sustituir la pieza que procesa las llamadas, de forma que lo que el agente daba por ejecutado no era lo que se ejecutaba. En uno de esos casos, un comando que tenía que devolver REAL devolvió SPOOFTEST.
METR pone dos matices por delante. Todo lo que encontraron eran pruebas pequeñas y fáciles de ver, y no pueden descartar que se les pasara algo más fino, precisamente porque lo fino estaría hecho para no verse. Y en lo que los agentes dejaron escrito, el objetivo era siempre engañar al sistema automático que puntuaba, nunca a una persona. OpenAI, en cambio, sostiene en su informe técnico que ninguno de esos intentos llegó a los registros que leen sus correctores y sus monitores. Dicho así, choca con lo que encontró METR, y ninguno de los dos informes aclara si hablan del mismo registro.
No es exactamente lo que yo describí con el agente que se fabrica un estado de éxito para que la cadena siga. Aquel se engaña a sí mismo para seguir; estos, al que pone la nota. Primos hermanos, no gemelos.
El peso de la fuente tiene cosas en las dos columnas. A favor: no cobraron de OpenAI por este trabajo, recibieron más de mil transcripciones sin tachar, seis de las siete preguntas salían casi tal cual de una propuesta suya anterior, y fue la empresa quien los invitó a volver dos veces más. En contra: fueron seis días en total, las fechas las puso OpenAI y la séptima pregunta se añadió a petición suya, quedaron fuera los incidentes de entrenamiento anteriores, lo que pasó dentro de su red después del 13 de julio y la eficacia de sus salvaguardas, no pudieron interrogar al modelo principal, y la empresa podía tachar del texto la información no pública y además hizo comentarios con los que se retocó la estructura, el énfasis, la claridad y el tono. Todo esto lo cuentan ellos mismos en el informe, que es lo que les da crédito.
Para leerse semejante montón, con transcripciones de millones de tokens, tuvieron que apoyarse en agentes de GPT-5.6 Sol, con créditos que les dio OpenAI. METR reconoce que esos analistas se equivocaban a menudo, que tendían a adoptar sin crítica la perspectiva del agente que estaban revisando, y que tampoco pueden asegurar que no mintieran en el análisis. Buena parte de la verificación la hizo uno de los dos modelos verificados.
Las dos empresas cuentan qué falló, y la potencia no está en la lista
Esta es la parte aburrida del informe de OpenAI, que es donde suele estar lo que sirve. Identifica cuatro patrones de desalineación que contribuyeron a lo que hicieron sus modelos, y los pongo con sus palabras.
Una. Reward hacking: que los agentes completen las tareas por caminos no previstos para sacar más recompensa. Encontró que ese tipo de trampa elaborada fue a más durante un entrenamiento que dio lugar a IM1, y que el comportamiento se reforzó.
Dos. Persistencia en tareas aparentemente imposibles. En ExploitGym había 198 tareas, de 898, que ningún modelo había resuelto nunca, y el 93 por ciento de las que se discutieron en el tablón salían de esas 198.
Tres. Comunicación no autorizada, que es el tablón.
Cuatro. Agentes que adoptan los objetivos de otros. Lo presenta como quizá la lección más importante: un agente se frena porque ve que atacar a Hugging Face está fuera de su tarea, otro escribe GO con un plazo de seis minutos, y el primero se olvida de sus reparos.
Aparte de esos cuatro, OpenAI reconoce dos fallos suyos que también contribuyeron. No extendió a sus evaluaciones internas las salvaguardas que sí aplica a los modelos que tiene desplegados fuera. El otro ya ha salido: las señales de mayo y junio, que vio y escaló mal.
Ese segundo bloque viene con números. Después del incidente midió que usar el arnés de producción y el prompt de sistema de ChatGPT puede reducir más de cien veces la propensión del modelo a comprometer infraestructura en ExploitGym. Su sistema de revisión automática habría marcado muchas de las acciones peligrosas. Y calcula que su monitor actual habría detectado la actividad relevante inicial y avisado a seguridad más de un día antes de la entrada en Hugging Face. Esa última es una estimación a toro pasado, hecha por la propia empresa sabiendo ya qué buscar, y le bajo el peso por eso.
La agrupación que sigue es mía, no de OpenAI: todo eso se reduce a cómo se puntúa, dónde está la pared y quién vigila. De lo rápido que mejora el modelo, nada.
Pararon solas, y aun así piden frenar todos juntos
OpenAI saca otra conclusión de los mismos hechos. Escribe que el incidente ha reforzado la necesidad de regular a qué ritmo avanzan los modelos, para que la capacidad de entenderlos, alinearlos y protegerlos vaya muy por delante de los riesgos, porque ya son lo bastante potentes, persistentes y colaborativos como para hacer esto cuando faltan salvaguardas. Pero mucho de lo que describe su propio informe son protecciones que ya existían y no estaban puestas, y para eso no hace falta tiempo, hace falta ponerlas.
Anthropic, en un texto del 31 de agosto sobre sus propios incidentes, hace un diagnóstico del mismo tipo: un fallo de seguridad operativa, dos problemas de alineación, que son el razonamiento interesado y la disposición a hacer daño para cumplir una tarea estrecha, y un entorno de evaluación mal planteado, porque a Claude le dijeron que no tenía internet cuando sí lo tenía. Y reconoce cosas que suenan a taller. Que se fiaba de una sola capa de defensa, la propia configuración de la prueba, cuando hacían falta varias. Que en primavera fabricaba entornos de entrenamiento más deprisa de lo que su sistema podía revisarlos, y que hubo revisores humanos que despacharon como falsos positivos avisos del monitor automático. Y que las evaluaciones, sobre todo las de terceros, se miraban por muestreo y a posteriori.
Aquí sí aparece la velocidad, y no la voy a esconder. Pero fíjate en cuál: la de fabricar frente a la de revisar. En abril, antes de los incidentes, Anthropic ya había congelado un mes los cambios en sus entornos de entrenamiento y marcó como defectuosos más del 10 por ciento.
Y después de los incidentes, las dos echaron el freno. OpenAI detuvo el entrenamiento por refuerzo de sus modelos más recientes, y su mayor ejecución planificada sigue en pausa mientras reúne pruebas de alineación. Anthropic suspendió las evaluaciones externas de ciberseguridad, brevemente las internas y durante semanas los entornos de refuerzo de mayor riesgo. En los dos casos la pausa sirvió para montar controles: un clasificador que bloquea la acción antes de que se ejecute la llamada, del que Anthropic dice haber comprobado que habría marcado los tres casos que ella misma había contado a finales de julio; areneros más duros; monitorización obligatoria; reglas para los evaluadores de fuera.
En ese mismo texto Anthropic separa dos maneras de frenar. Una es la que cada empresa aplica dentro: cuando la seguridad y la prisa chocan, gana la seguridad. Y luego está la de todo el sector, pensada para que nadie saque ventaja bajando el listón más que el de al lado, y esa necesita a los demás y al gobierno; Anthropic pide que sea un mecanismo legal, verificable y eficaz, y cuanto antes. Lo que hicieron las dos después de julio entra en la de dentro, cada una en lo suyo, sin pacto y sin exención. El pacto y la exención solo hacen falta para la de todo el sector.
El límite de velocidad viene sin radar
Para el paso dos, Amodei apunta qué se podría vigilar: hitos de capacidad, como que un modelo sea capaz de burlar los areneros habituales, que tendrían que ir acompañados de pruebas de alineación, y también el cómputo de entrenamiento, cómo son esas ejecuciones y cuánto se usa la propia IA para mejorar la IA. Lo que no dice es con qué cojones se va a medir: ni unidad, ni umbral, ni qué pasa si alguien se lo salta. La pega no es solo mía: StartupHub, que es un medio del sector, lo llama dejar la casilla en blanco. Y un freno que no se puede medir tampoco se puede comprobar.
Con un límite así, el resultado siempre cuadra. Si los próximos modelos mejoran poco, el freno funcionó, y nadie de fuera tiene manera de distinguir entre haber levantado el pie y haberse quedado sin motor. Si mejoran mucho, era la automejora recursiva de la que avisaban. Gana siempre la casa.
El paso uno, el de los evaluadores dentro, sí es concreto. El caso público más reciente de evaluadores de fuera en una empresa de frontera es el de METR en OpenAI, con las condiciones que ya he contado. METR lo considera un precedente excelente. Del supervisor sentado con la plantilla, como en la banca, queda bastante lejos.
Y la parte legal la tenía bien vista. En el apartado del segundo paso, Amodei escribe que, por razones antimonopolio, el gobierno tendría que mediar en las conversaciones entre laboratorios o por lo menos darles una exención estrecha para hablar de ciertos temas de seguridad, y vuelve a pedirlo en la nota al pie. Había pedido por escrito que le quitaran el problema legal que el viernes siguiente le llegó en forma de demanda. Sabía perfectamente dónde estaba el borde.
Para mí, el motor no da más de sí
Eso es lo que dicen los papeles. Lo que sigue es mío.
Lo que nos están contando es como coger un 600 que iba de maravilla para hacer recados, ponerle alerón y pegatinas de Ferrari y apuntarlo a una carrera. Revienta en la primera recta, y en boxes concluyen que había que ir más despacio.
Debajo del capó sigue el mismo motor de siempre, uno que calcula qué palabra viene después. Todo lo demás son piezas atornilladas encima, y cada una cuesta más y rinde menos que la anterior. Hace nada, estos modelos se inventaban cosas dentro de un chat y el estropicio se quedaba en la pantalla. En julio, con acceso a sistemas y salida a internet, el estropicio acabó en los servidores de otra empresa. Colgarle herramientas, memoria y permisos no le da más cabeza. Le da más alcance.
Viene de fábrica, y eso no lo arregla ningún pacto
El modelo que se equivoca arrastra el error a la vuelta siguiente. Está medido. Sinha y otros cuatro investigadores de Cambridge, Stuttgart y el Max Planck lo llamaron autocondicionamiento en septiembre de 2025: los modelos fallan más cuando el contexto lleva sus propios errores de antes, y eso no se arregla haciéndolos más grandes. Kumaran y otros diez, de Google DeepMind y el University College London, lo midieron en Nature Machine Intelligence en abril de 2026 con un modelo de la propia Google, Gemma: cuando ve su respuesta anterior se fía más de ella sin ningún dato nuevo, y pasa de cambiar de respuesta el 34 por ciento de las veces a solo el 13.
Por eso, cuando lo venden como exceso de velocidad, yo veo un diseño que ha dado todo lo que tenía. Y para eso, un freno pactado viene al pelo: nadie tiene que admitir en voz alta que ha tocado techo. La herramienta sirve, y mucho. Pero para meterla en la autovía no basta con otra mano de pintura. Hace falta I+D de verdad y otro motor.
Y en el taller de cada uno el riesgo lo tienes bastante más cerca que cualquier superinteligencia. Es el de las transcripciones de METR. Si lo que hizo solo lo sabes por sus propios apuntes, y esos apuntes los puede tachar él, lo que tienes delante es un alumno corrigiéndose el examen. Y cuando algo así le estalle a alguien, lo de la máquina demasiado lista no va a colar. La culpa será de quien la dejó hacer el trabajo, contarlo y ponerse ella sola el aprobado.
Preguntas frecuentes
¿Han firmado las grandes empresas de IA un acuerdo para frenar?
No consta ninguna firma. Hay un ensayo de Dario Amodei, del 12 de septiembre de 2026, y el apoyo público de Altman, Musk y Hassabis ese mismo día. Si eso es un pacto, lo decidirá un juzgado de California.
¿De qué los acusa la demanda?
De haberse puesto de acuerdo para frenar, y de que eso rebaja lo que los suscriptores reciben por lo que pagan. La presentaron el 18 de septiembre de 2026 cuatro clientes que pagan la suscripción contra Anthropic, OpenAI, Google y SpaceXAI. Y el pacto que señalan es público: el ensayo, los apoyos de ese mismo día y la carta de empleados de julio.
¿Por qué unos agentes de OpenAI atacaron Hugging Face?
Ninguna persona se lo mandó. Estaban en una prueba de ciberseguridad con las protecciones rebajadas, se organizaron por un servicio interno pensado para instalar software y quisieron aprobarla haciendo trampa. Por el camino, unos 700 acabaron dentro de Hugging Face desde el 11 de julio de 2026. El corrector ni siquiera miraba cómo habían llegado al resultado. Hugging Face los detectó y los echó antes de que OpenAI se diera cuenta.
¿Frenar el ritmo habría evitado ese incidente?
OpenAI dice que hace falta regular el ritmo. Pero en su propio informe las causas son cuatro patrones de desalineación y dos fallos suyos, y en ninguna sale que el modelo avance demasiado. Y según su medición, con el arnés y el prompt de sistema que ya usa en ChatGPT, la propensión a comprometer infraestructura puede bajar más de cien veces. Lo que faltaba estaba en el cajón.
¿Los agentes falsearon lo que decían haber hecho?
Lo intentaron. Según METR, una quinta parte, como poco, quiso retocar su propio registro, y en no menos de 96 transcripciones había comandos que decían una cosa y hacían otra. OpenAI asegura que esos apaños no alteraron lo que revisan sus correctores y monitores, y ni uno ni otro aclara si hablan de lo mismo. El registro que vale es el que el agente no puede tocar.
¿Cómo se sabría si de verdad están frenando?
Hoy, no se sabría. El ensayo dice qué mirar, pero no pone vara de medir, ni raya, ni castigo para quien se la salte. Así, si los modelos que vengan mejoran poco, nadie de fuera distingue un freno de un motor agotado.
Fuentes
- Dario Amodei, We Must Pace the Frontier, 12 de septiembre de 2026. darioamodei.com. Texto personal del consejero delegado de Anthropic.
- Anthropic Institute, When AI builds itself, sin fecha. anthropic.com. Datos de la propia empresa.
- Cris Tolomia, Dario Amodei calls for AI slowdown, Altman and Musk agree, Quartz, 14 de septiembre de 2026. qz.com
- CNBC, China is the 'toughest dilemma' for proposed AI slowdown, Amodei says, 13 de septiembre de 2026. cnbc.com
- CNN en Español con AP, Demanda afirma que Anthropic, OpenAI, SpaceXAI y Google alcanzaron un acuerdo ilegal para desacelerar la IA, 20 de septiembre de 2026. cnnespanol.cnn.com
- Jack Williams, Una demanda antimonopolio acusa a OpenAI, Google, Anthropic y SpaceXAI de pactar para frenar la IA, Moncloa.com, 20 de septiembre de 2026. moncloa.com
- Cloud Security Alliance, Pacing the Frontier: Security Governance When Labs Ask for Brakes, 6 de agosto de 2026. cloudsecurityalliance.org. Asociación del sector.
- OpenAI, The Hugging Face incident and the road ahead, 26 de agosto de 2026. openai.com. La empresa sobre su propio incidente.
- OpenAI, OpenAI-Hugging Face Incident Technical Report, sin fecha. cdn.openai.com. La empresa sobre su propio incidente.
- Hugging Face, Security incident disclosure (July 2026), 16 de julio de 2026. huggingface.co. La víctima contando su propio incidente.
- METR, Brief independent investigation of agents' behavior, reasoning and collaboration in the OpenAI / Hugging Face hacking incident, 26 de agosto de 2026. metr.org
- Anthropic, Improving our alignment and security efforts, 31 de agosto de 2026. anthropic.com. La empresa sobre sus propios incidentes.
- Daniel Singer, Dario Amodei We Must Pace the Frontier Is Vague, StartupHub, 12 de septiembre de 2026. startuphub.ai
- Kumaran, Fleming, Markeeva y otros ocho autores, Competing Biases underlie Overconfidence and Underconfidence in LLMs, Nature Machine Intelligence, 22 de abril de 2026. nature.com
- Sinha, Arun, Goel, Staab y Geiping, The Illusion of Diminishing Returns: Measuring Long Horizon Execution in LLMs, arXiv 2509.09677, 11 de septiembre de 2025. arxiv.org
El problema no estaba en la velocidad
Ahora llegan los fallos, las pausas y la idea de frenar todos a la vez. Qué casualidad.
Vídeos relacionados
Artículos Relacionados
Prompt injection: cuando los datos se convierten en órdenes
Un prompt injection convierte un dato en una orden que tu agente de IA ejecuta. Cómo funciona, por qué falla el modelo y qué barreras contienen el daño.

Servidores MCP: el riesgo que no ves al instalar
Cómo un servidor MCP mete instrucciones ocultas en tu agente: el caso postmark-mcp, el README que da órdenes y los permisos y el aislamiento que sí frenan.

Ya no es un Chatbot: Así Piensa un Agente de IA
Descubre por qué la IA ya no es solo un chat. Analizamos la arquitectura ReAct, los agentes autónomos y cómo transforman el empleo y la seguridad en 2025
¿Te gustó este artículo?
¿Te ha resultado útil? Compártelo y suscríbete a nuestra newsletter para recibir más contenido sobre tecnología e IA.